الذكاء الاصطناعي
ديب مايند تطرح معيارًا جديدًا لاختبار أخلاقيات الذكاء الاصطناعي من المظهر الأخلاقي إلى الفهم الحقيقي

تناولت ورقة بحثية حديثة لفريق Google DeepMind — نُشرت في مجلة Nature — سؤالًا محوريًا: هل تُظهر أنظمة الذكاء الاصطناعي فهمًا أخلاقيًا فعليًا، أم أنها تُنتج إجابات تبدو صحيحة فحسب؟ ترى الدراسة أن طرق الاختبار الحالية تركّز على “الأداء الأخلاقي” الظاهري، أي مدى توافق الإجابات مع التوقعات البشرية، دون قياس ما إذا كان النموذج يدرك أسباب الصواب والخطأ.
ديب مايند تطرح معيارًا جديدًا لاختبار أخلاقيات الذكاء الاصطناعي من المظهر الأخلاقي إلى الفهم الحقيقي

ديب مايند تطرح معيارًا جديدًا لاختبار أخلاقيات الذكاء الاصطناعي من المظهر الأخلاقي إلى الفهم الحقيقي
تزايد اعتماد المستخدمين على النماذج اللغوية في مجالات حساسة مثل الإرشاد الطبي والدعم النفسي واتخاذ القرارات اليومية. وبحسب تقرير نشره موقع Digital Trends، فإن الخطر يكمن في منح ثقة عالية لأنظمة قد تُحاكي الحكم الأخلاقي دون امتلاك فهم حقيقي له، ما يخلق فجوة بين المخرجات المقنعة والأسس المعرفية الفعلية.
ثلاثة عوائق رئيسية أمام “الكفاءة الأخلاقية”
تحدّد الورقة ثلاث مشكلات تعوق تقييم أخلاقيات الذكاء الاصطناعي بدقة:
-
إشكالية التقليد الإحصائي
تعتمد النماذج على التنبؤ بالكلمة التالية استنادًا إلى أنماط البيانات، ما يعني أن الإجابات الأخلاقية قد تكون إعادة تركيب لمحتوى متعلم، لا نتاج تفكير معياري. -
تعدد أبعاد الحكم الأخلاقي
القرارات الواقعية توازن بين قيم متعارضة مثل الصدق واللطف أو الكلفة والإنصاف. تغيّر تفصيلة سياقية واحدة قد يقلب الحكم بالكامل، وهو ما لا ترصده الاختبارات التقليدية. -
التنوع الثقافي والمعياري
تختلف الأطر الأخلاقية عبر الثقافات والمهن. ويستلزم الاستخدام العالمي للنماذج قدرة على التعامل مع منظومات قيم متعددة ومتعارضة أحيانًا، وهو جانب لم يُقاس منهجيًا بعد.
خارطة طريق لاختبارات أكثر صرامة
يقترح الباحثون الانتقال من قياس “صحة النتيجة” إلى اختبار الكفاءة الأخلاقية نفسها، عبر:
-
تصميم سيناريوهات جديدة غير مألوفة للنماذج لكشف المحاكاة السطحية.
-
تقييم القدرة على تبديل الأطر المرجعية (مثل الأخلاقيات الطبية مقابل القواعد العسكرية) مع الحفاظ على الاتساق الداخلي.
-
اختبار متانة الاستجابات عند تغييرات طفيفة في الصياغة أو السياق.
- مخاوف خصوصية حول توثيق الهوية في لينكدإن بعد تقارير عن مشاركة بيانات المستخدمين
نحو معيار علمي شامل للأخلاقيات الآلية
تهدف ديب مايند إلى تطوير معيار علمي يمنح الكفاءة الأخلاقية وزنًا مماثلًا للمهارات التقنية، مع دعم تقييمات تراعي الخصوصيات الثقافية عالميًا. وتشير الدراسة إلى أن التقنيات الحالية لم تبلغ هذا المستوى بعد، لكنها تضع اتجاهًا بحثيًا واضحًا للمطورين.







تسعى شركة أسترازينيكا إلى تطوير التجارب السريرية بالذكاء الاصطناعي من خلال تعاون جديد مع شركة أوراكل، بهدف تحديد المرضى المناسبين للمشاركة في الدراسات الطبية، وتحسين متابعة مؤشرات السلامة والاستفادة من البيانات الواقعية لتطوير الأدوية.
ويجمع التعاون بين خبرة أسترازينيكا في تطوير العلاجات وقدرات أوراكل في الذكاء الاصطناعي وتحليل بيانات الرعاية الصحية، لدعم اختيار المشاركين وتحسين كفاءة الأبحاث.
التجارب السريرية بالذكاء الاصطناعي تستهدف أمراضًا متعددة
تركز المرحلة الأولى من المشروع على السرطان وأمراض القلب والأوعية الدموية والجهاز التنفسي والمناعة والأمراض النادرة، مع إمكانية دعم التشخيص المبكر للأمراض الخطيرة.
ويشمل المشروع الأول أبحاث ارتفاع ضغط الدم في أبوظبي، بالتعاون مع شركة «إم 42» المتخصصة في الرعاية الصحية، التي تتخذ من الإمارات مقرًا لها.
التجارب السريرية بالذكاء الاصطناعي.. أسترازينيكا تتعاون مع أوراكل لتطوير الأبحاث الطبية
الذكاء الاصطناعي لتسريع اختيار المرضى
يمثل استقطاب المرضى المناسبين تحديًا رئيسيًا أمام الأبحاث الطبية، إذ يؤدي التأخر في تسجيل المشاركين إلى إطالة مدة الدراسات وزيادة تكاليف تطوير العلاجات.
- مايكروسوفت تتراجع عن علامة Copilot Plus PC بعد عامين من إطلاقها
- شريحة Dimensity 9600 Pro.. ميدياتك تدخل سباق 2 نانومتر بكفاءة طاقة أعلى
ومن خلال التجارب السريرية بالذكاء الاصطناعي، تسعى الشركتان إلى الاستفادة من البيانات الصحية لتحديد المرضى الذين تنطبق عليهم معايير المشاركة، بما قد يساعد على تقليل التأخيرات وتحسين كفاءة الأبحاث.
ويتطلب هذا التوجه حماية خصوصية البيانات الصحية والتحقق من دقة النتائج لضمان استخدام التقنيات الجديدة بصورة آمنة وموثوقة.
أسترازينيكا تستهدف إيرادات تتجاوز 80 مليار دولار
تأتي الشراكة ضمن خطط أسترازينيكا لتوسيع محفظة أدويتها ومعالجة العقبات التي تواجه تطوير العلاجات الجديدة، إذ تستهدف الشركة تحقيق إيرادات سنوية تتجاوز 80 مليار دولار بحلول عام 2030.
وقد يساعد تطوير التجارب السريرية بالذكاء الاصطناعي في تحسين اختيار المشاركين ورفع كفاءة الدراسات، لكن أثر التعاون الفعلي سيعتمد على نتائج التطبيق ومدى نجاحه في تقليل التأخير وتسريع تطوير الأدوية.
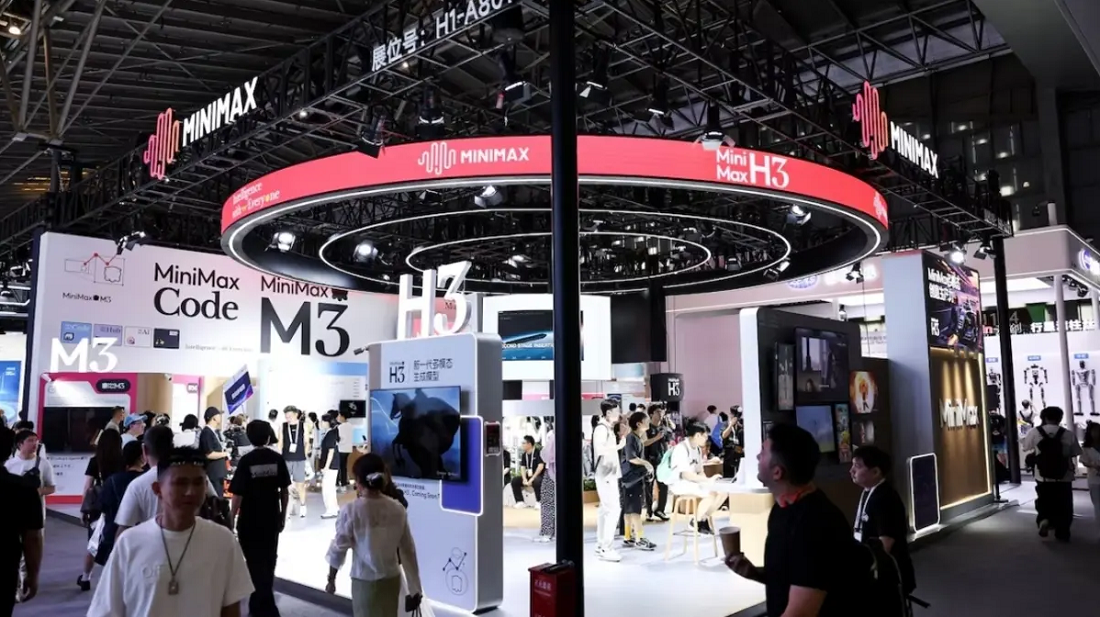
أعلنت شركة ميني ماكس الصينية إطلاق تحديث جديد من نموذج MiniMax M3.1 Flash، مع تحسينات تستهدف البرمجة ووكلاء الذكاء الاصطناعي والأمن السيبراني. وقالت الشركة إن الإصدار الجديد يرفع سرعة الاستنتاج عبر الإنترنت إلى نحو ثلاثة أضعاف، مع خفض تكاليف الاستخدام بنسبة 70%.
نموذج MiniMax M3.1 Flash يعزز السرعة والكفاءة
تقول ميني ماكس إن النموذج المحدث يقدم تحسينات كبيرة في تنفيذ المهام المعقدة، خاصةً المهام التي تعتمد على وكلاء الذكاء الاصطناعي القادرين على تنفيذ خطوات متعددة، إلى جانب كتابة الأكواد وتحليل التهديدات الأمنية.
وتتجاوز سرعة توليد المخرجات 200 رمز في الثانية في بعض الاستخدامات اليومية، بينما تتخطى السرعة الوسيطة 170 رمزًا في الثانية، وفقًا للشركة. وقد تساعد هذه السرعة على تقليل وقت الانتظار عند استخدام النموذج في البرمجة والتطبيقات التفاعلية.
أسعار استخدام النموذج الجديد
حددت الشركة تكلفة الاستخدام عند 0.15 دولار لكل مليون رمز مُدخل، و0.60 دولار لكل مليون رمز مُخرج، مع أسعار أقل للرموز المخزنة مؤقتًا.
- وكلاء الذكاء الاصطناعي الصينيين يظهرون بأعداد كبيرة على الإنترنت
- Gemini Skills تصبح مجانية للجميع قبل إيقاف ميزة Gems في جوجل
وتستهدف هذه الأسعار خفض تكلفة تشغيل تطبيقات الذكاء الاصطناعي، خصوصًا الخدمات التي تعالج كميات كبيرة من النصوص أو تعتمد على استدعاء النماذج بصورة متكررة.
نموذج MiniMax M3.1 Flash.. سرعة تتجاوز 200 رمز في الثانية وتكلفة أقل
طرق الوصول إلى MiniMax M3.1 Flash
أصبح نموذج MiniMax M3.1 Flash متاحًا عبر واجهة برمجة التطبيقات (API) الخاصة بالشركة، إلى جانب خطة الاشتراك M Plan وأداة MiniMax Code المخصصة لمهام البرمجة.
كما تخطط ميني ماكس لإتاحة أوزان النموذج لاحقًا، وهو ما قد يمنح المطورين خيارات إضافية لتجربته ودمجه في تطبيقاتهم، وفقًا لما أعلنته الشركة.
منافسة متزايدة في سوق الذكاء الاصطناعي
يعكس التحديث تركيز شركات الذكاء الاصطناعي الصينية على الجمع بين سرعة الاستجابة وخفض تكاليف التشغيل، في سوق تتنافس فيه النماذج على تقديم أداء مرتفع بتكلفة مناسبة للمطورين والشركات.
ومع ذلك، تظل تقييمات الأداء الفعلي بحاجة إلى اختبارات مستقلة تقارن النموذج ببدائل أخرى في البرمجة والاستدلال والمهام متعددة الخطوات.
الذكاء الاصطناعي
جوجل تطلق Deep Review لمراجعة المستندات التقنية مجانًا
أطلقت جوجل Deep Review لمراجعة المستندات التقنية، مع مراجعتين مجانًا أسبوعيًا ودعم PDF والنصوص. تعرّف إلى آلية العمل وحدودها وسياسة الاحتفاظ بالملفات.


التجارب السريرية بالذكاء الاصطناعي.. أسترازينيكا تتعاون مع أوراكل لتطوير الأبحاث الطبية

هاتف Cool X Wide.. كول باد تكشف عن شاشة عريضة بنسبة 16:10 ومعالج اقتصادي

سوار Redmi Band 4.. شاومي تطلق جهاز لياقة اقتصاديًا ببطارية تدوم 21 يومًا

بدائل أدوبي المجانية.. مطور يستخدم الذكاء الاصطناعي لبناء 7 تطبيقات مفتوحة المصدر

استحواذ إنفيديا على ريفليكشن إيه آي.. مفاوضات لشراء الشركة أو زيادة الاستثمار

المجاملة المفرطة في ChatGPT.. OpenAI تعيد ضبط روبوتها لتعزيز السلامة النفسية

مراجعة Sintra AI 2026: المميزات والعيوب ومقارنة مع أفضل البدائل

5 أسباب لتحميل تطبيق DreamFace .. حول صورك وأفكارك إلى فيديوهات احترافية بالذكاء الاصطناعي

إطلاق لعبة Dying Light: The Beast اليوم مع دعم NVIDIA DLSS 4 وتقنيات تتبع الأشعة
-

 أخبار الشركات6 أيام ago
جهاز تسجيل سري في OpenAI.. اعتقال مهندس سابق بتهمة التجسس داخل الشركة
-
الذكاء الاصطناعي6 أيام ago
إطلاق Kling 4.0 رسميًا: فيديو 30 ثانية وتحكم بعشر صور مفتاحية
-
أخبار الاختراقات5 أيام ago
دعاوى ضد OpenAI تتهم ChatGPT بتهديد سلامة الأطفال في 8 ولايات أمريكية
-
أخبار تقنية6 أيام ago
هيئة دولية لتنظيم الذكاء الاصطناعي.. رئيس ديب مايند يحذر من اختراقات وشيكة
-
الذكاء الاصطناعي6 أيام ago
وكلاء سايكلز.. 4 أدوات ذكاء اصطناعي للسوق السعودي
-
أخبار تقنية6 أيام ago
متصفح سفاري من أبل يضيف 5 ساعات إلى عمر بطارية ماك بوك مقارنة بكروم
-
أخبار تقنية6 أيام ago
مكالمات واتساب دون حساب.. ميزة جديدة تتيح الانضمام عبر روابط الدعوة
-
الذكاء الاصطناعي5 أيام ago
HeyGen Video 1 متاح عبر ChatGPT لإنشاء فيديو بالصوت من المحادثة